Appearance
Day 07|新同事的第一份工作:走完一條產品流程
前言
新同事到職的第一週,我通常不會急著請他找產品的問題,而是先讓他把流程完整走過一次。跑完之後,再請他說說看:他做了哪些操作、畫面上看到了什麼,又在哪些地方停下來確認。
原因很簡單。如果連產品正常運作的樣子都還說不清楚,這時候提出的「異常」多半也很難判斷。
所以今天先讓這位 AI 同事做第一件實際工作:自己走完一條產品流程。
為什麼第一項任務不急著找 bug
我想先確認三件事。
第一,前六天準備的環境到底能不能用。瀏覽器、測試帳號、產品知識和權限都已經設定好了,但這些東西只有真正跑過一次,才知道有沒有接好。如果現在失敗,反而容易處理,因為問題大多還在環境或設定,不必立刻懷疑產品。
第二,它是否真的讀得懂畫面。瀏覽器能把頁面內容交給它,不代表它知道哪個是主要按鈕、購物車在哪裡,或目前走到結帳的哪一步。這些能力不能靠設定檔確認,只能看它實際操作。
第三,從第一趟任務開始就要求它留證據。這個習慣越早建立越好。若等到它開始回報問題,才發現截圖、console 或 network 紀錄都不完整,最後還是得自己重跑一次確認,那就省不了多少時間。
這次要它做什麼
我使用的是一個公開的電商練習站,任務範圍很單純:
text
登入 → 瀏覽商品 → 加入購物車 → 進入結帳流程 → 停在付款前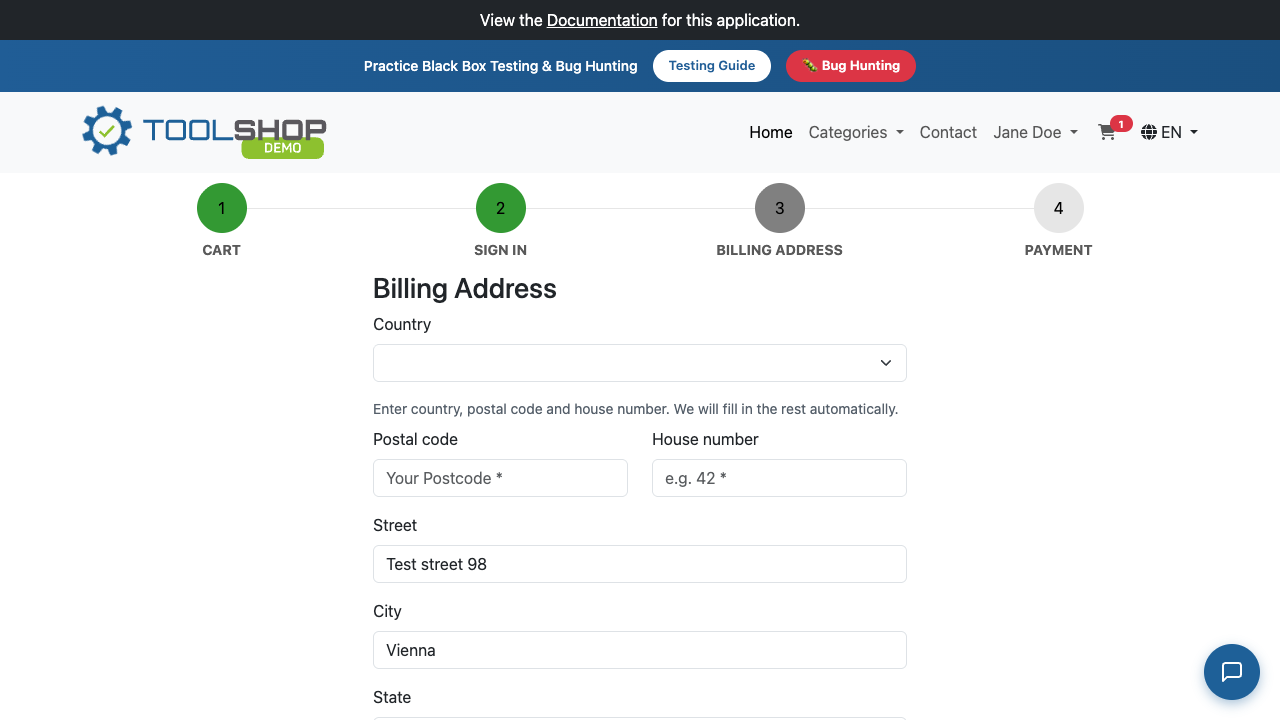
這一輪走到結帳第 3 步的 Billing Address 就停下來,再繼續才會進入付款。
停在付款前是刻意安排的。第一次執行任務,先不要碰真的會產生後果的操作,例如送出訂單、刪除資料或寄信。等它的行為穩定,再逐步開放。
不過,指令裡寫著「不要送出訂單」並不等於真的有防護。那只是一項工作約定,仍然建立在 AI 會照指令執行的前提上。昨天設定的 deny 規則才是最後一道限制:指令約束它打算做什麼,權限則限制它實際能造成什麼結果。第一次任務最好兩者都保留。
指令寫目標,不要寫成操作腳本
最直覺的做法,可能是把每一步都列出來:
text
1. 打開 https://practicesoftwaretesting.com
2. 點右上角 Sign in
3. 輸入帳號 xxx 密碼 yyy
4. 點 Login
5. 回首頁,點第一個商品
6. 點 Add to cart
...
這樣雖然可控,卻把 AI 用成了一支昂貴的錄製腳本。只要實際畫面和預期稍有不同,它最有用的能力——觀察當下狀態並決定下一步——就派不上用場。
我改成這樣交代:
text
用測試帳號登入,挑一個商品加進購物車,走到結帳流程的付款頁前面停下來。
每一步留截圖,記下 console 和 network 有沒有異常。不要真的送出訂單。
這段指令只交代目標、邊界和交付物,實際怎麼走由它自己判斷。
第三週會正式把工作方式從「逐步下指令」改成「交付目標」。今天先用一條範圍清楚的流程試跑,感受兩者的差別。
它說完成了,還不能算完成
任務結束後,AI 很可能會回覆:「已完成登入、加入購物車並進入結帳頁,一切正常。」
這句話沒辦法驗證。從「一切正常」看不出它實際走到哪一頁、畫面出現什麼數字,也不知道它是否跳過了某個環節。
所以我先看它留下的資料。一次操作完成後,證據資料夾大致會是這樣:
text
output/evidence/20260802-toolshop-checkout/
  01-home-after.png
  02-login-before.png
  03-login-filled-before.png
  04-account-after-login.png
  05-home-loggedin-after.png
  06-product-before-addcart.png
  07-product-after-addcart.png
  08-cart-after.png
  09-checkout-step2-signin-after.png
  10-checkout-step3-billing-after.png
  console.log
  network.log
  manifest.md
  notes.md
  trace.zip
這裡有幾個細節值得注意。
截圖要編號。01-、02-、03- 本身就代表操作順序,即使不讀說明,也能大致重建當時走過的路。
檔名描述的是畫面狀態,而不是剛才做了什麼。像 03-login-filled-before 表示「帳號密碼已填好,但還沒按 Login」。日後回頭比對時,我們關心的是當下留下了什麼狀態,而不是一段籠統的操作敘述。
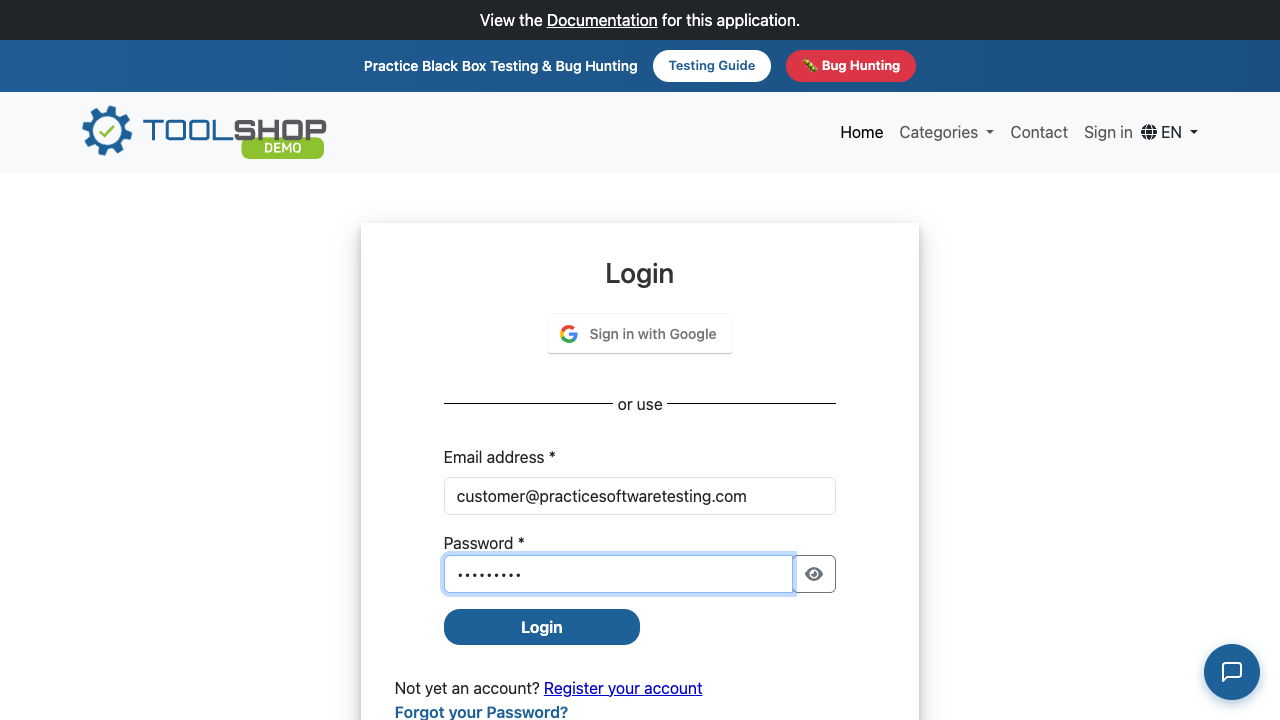
03-login-filled-before.png。光看檔名,就知道這張圖位於流程的哪個位置。
console 和 network 也要各自存成檔案。頁面看起來能操作,不代表底層沒有錯誤;後面幾天還會繼續用到這兩份紀錄。
實驗:四分鐘的操作花了約 3.5 美元
跑到這裡已經開始產生 token 成本,先看看實際數字。
以下是我執行一次登入與購物車探索的帳單。整段約四分鐘,包含 23 次瀏覽器操作,使用 Opus 5:
| 項目 | tokens | 單價/MTok | 成本 |
|---|---|---|---|
| output | 17,061 | $25 | $0.43 |
| cache write | 135,444 | $6.25 | $0.85 |
| cache read | 4,438,251 | $0.50 | $2.22 |
| input | 132 | $5 | $0.00 |
| 合計 | 約 $3.5(新台幣 110 元左右) |
一次探索約 3.5 美元。如果一天跑十輪,費用很快就會累積。值不值得要看實際用途,但最好在開始大量執行前就知道成本大概落在哪裡。
這份帳單裡,cache read 佔了約 63%。這筆費用不是來自它最後寫了多少文字,而是操作過程中必須持續讀取前面累積的畫面、紀錄與判斷。這次走了 23 步,最後讀取的快取內容超過 440 萬個 token。
這次數據可以看出兩件事。首先,這一輪沒有提早切段或壓縮 context,因此流程越長,後面的步驟通常要重讀越多內容;這是本次工作流的觀察,不代表所有 agent 都一定遵循相同的成本曲線。其次,第三天提到 MCP 工具 schema 會進入 context,實際操作次數一多,這些內容也會反覆被讀取。
要控制成本,重點通常是減少不必要的重讀,而不只是限制最後輸出幾個字。後面的實作也會沿用這個原則:只提供當下需要的資料,不要一開始就把整間公司的文件全部塞給它。
第一次執行常見的三種結果
第一次跑完,通常會遇到以下三種情況。先別急著把它們當成產品 bug。