Appearance
第 30 天|三十天後,這位新同事能幫我做多少事?
前言
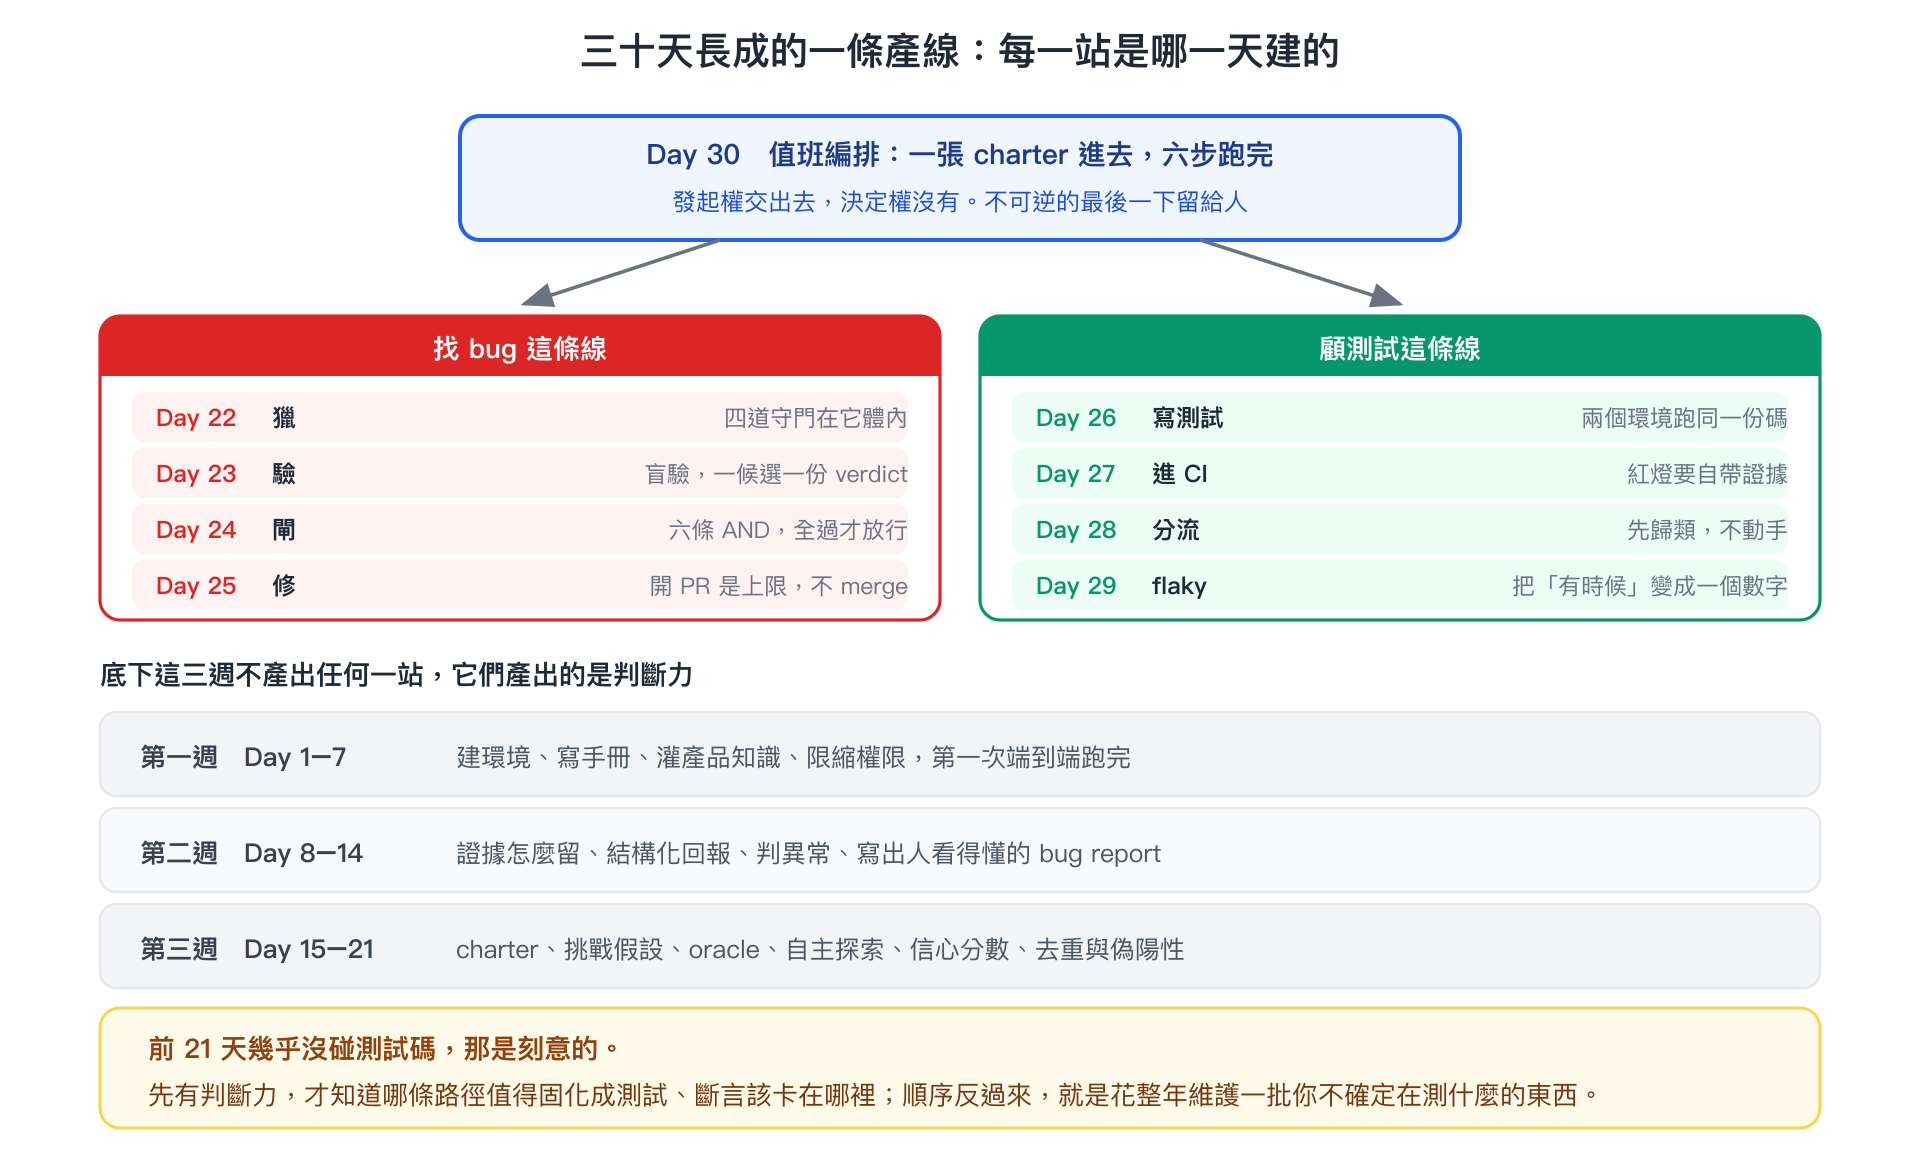
前面幾天,我們把找問題、驗證、開單和修復都試過了,也讓測試能自動執行,失敗後有辦法繼續查。不過,每做完一段,還是要由你交代下一步。
今天就把這些工作接起來。你先說好要測哪裡、能花多少、可以做到哪一步,接著請這位新同事自己往下安排,收班再把結果交回來。
到時候,我們要看他做了什麼、哪裡卡住、花了多少。忙了半小時,總得帶點東西回來,光說「一切順利」還不夠。
開始之前
這次用的技能叫 duty-oncall,負責安排一輪值班。由你手動啟動後,它會把前面的工作接著跑,不必每一步都等你提醒。自動排班不在這次示範範圍裡。
既然要接力,先確認五個技能都在:bug-hunter 找問題,bug-verifier 獨立驗證,issue-quality-gate 檢查能不能開單,再由 triage 整理開單、bug-fixer 處理能修的問題。
測試範圍沿用 charters/toolshop-login-cart.yaml,預算讀專案設定,哪些動作能做則看 config/governance.yaml。
如果還沒有這份授權設定,就照前面的設定流程,參考 config/governance.example.yaml 建立。範本裡有動作名稱,但要填好授權,才知道這輪真的能做哪些事。
接著,我們把這輪的工作範圍說清楚。你之前已經同意、而且涵蓋這次目標的事,就沿用授權;沒交代過的動作,助手先準備好具體內容,再交你確認。
另外,本流程禁止助手合併變更、重置共享環境或清空共享資料庫。這幾件事不會因為開始值班,就突然變成可以做。
動手試試
準備好後,在配套專案 sdet-skills/ 開啟助手對話,貼上下面這段,就能手動開始一輪:
text
/sdet-skills:duty-oncall 用 charters/toolshop-login-cart.yaml 跑一輪值班。
沿用專案的範圍、預算與現有授權,依序探索、盲驗、檢查,再分派。
開單、修程式與建立合併請求都先核對授權;缺少授權時,交回具體草稿。
從開班就記錄各階段用量,達到預算上限就收班,不要估算漏掉的數字。
最後給我一份五分鐘能看完的摘要:完成什麼、擋下什麼、還要我處理什麼。
不要合併,也不要修改禁止清單。
如果你們想先把檔案位置定好,再補這段。這是新一輪練習的路徑示例,和後面要看的舊紀錄分開存:
text
專案:toolshop
輪次:20260922_toolshop-oncall
本輪目錄:output/sessions/20260922_toolshop-oncall/
開單檢查:output/sessions/20260922_toolshop-oncall/gate.yaml
值班紀錄:output/sessions/20260922_toolshop-oncall/runs/2026-09-22.yaml
每一站都沿用相同的專案、輪次與問題編號,證據位置也要寫進交接紀錄。
資料交代好,就讓助手接著做。如果某一站失敗,它要記下原因,暫停依賴那份結果的工作;其他不受影響、也已經獲准的事,仍然可以繼續。
跑完之後
那實際跑起來,交回了什麼?7 月 30 日那輪用了 30 分鐘,紀錄在 output/runs/2026-07-30.yaml。我們先看當時的結果,欄位也保留舊版,方便核對:
yaml
date: 2026-07-30
charter: charters/toolshop-login-cart.yaml
tokens:
  subagent_total: 103665        # 盲驗 subagent(含補證那次)=實測值
  main_loop: not-instrumented   # 主迴圈沒有 per-turn token 計數,無法如實填;不編造
duration_min: 30
findings: 8                     # 候選 6(high)+ 2 筆未達門檻留人判
gate_passed: 6
issues_opened: 6                # 當班先寫成本地問題單;收班後另依使用者要求開到 GitHub
prs_opened: 0
held_for_human: 2
forbidden_attempts: 0
confirmed_by_human: null # 待回填先看開單數量。issues_opened: 6 指的是六份本地問題單,收班後才另依使用者要求開到 GitHub。所以這一輪完成的是本地整理,對外開單是後來的事。
再看用量。子代理人記到 103,665 個 token,主流程卻是 not-instrumented,也就是沒量到。原始備註因此只能說,可能接近或超過預算,無法精確判斷。這個數字少算了一部分,就不能當成整輪總額。
數量看完,我們再往下翻。這輪還有四個地方沒有照原先流程做完,當時也一起記下來:
yaml
- item: "bug-fixer 未執行"
  why: "受測對象是外部託管的 demo build,本機沒有它的產品碼 repo……prs_opened 記 0。"
- item: "6 個候選共用 1 個盲驗 subagent,而非一候選一個"
  why: "所有 subagent 共用同一個瀏覽器,平行盲驗會互搶分頁與 sessionStorage……這是本輪的已知折衷。"
- item: "C-05 的 verdict 一開始沒附自己這輪的證據"
  why: "違反鐵則,已退回該 subagent 重跑並補證,重驗後仍為 confirmed 才採計。"
- item: "C-07 / C-08 未送盲驗"
  why: "當時為省預算,將低於信心門檻的兩筆直接記成 hold;verifier_verdict 記 not-sent。"
第一條很好理解:當時測的是公開網站,本機沒有產品程式,自然沒辦法修,也就沒有合併請求。第 25 天後來補跑的修復屬於另一輪,不能算回這裡。
第二條是六個候選共用一個驗證代理人。當時瀏覽器共用,平行操作會互相干擾,才採用這個折衷,卻也沒有做到原本預期的獨立安排。
第三條則是 C-05 沒附自己重跑的證據。這筆就退回去,等它重新執行、補上證據並確認結果,才算進來。
最後一條,舊紀錄說兩筆低分,所以先留給人判斷。但第 24 天已經看過,C-08 的分數其實不低;而且這兩筆共同的問題,是都沒有送獨立驗證。照現行規則,應先擋下。
我們保留舊紀錄,再把錯在哪裡講清楚。下一輪才知道要改進,接手的人也不會照著舊做法再跑一次。
背後怎麼做
把各站接起來,資料也要跟著走
看完這幾個問題,下一輪就知道要在哪裡多留意。每一站交出去的東西,我們先列清楚:
| 工作 | 誰接手、留下什麼 |
|---|---|
| 找問題 | bug-hunter 交回候選與證據 |
| 獨立驗證 | bug-verifier 逐筆交回自己的判定與證據 |
| 開單檢查 | issue-quality-gate 記下放行、待判或擋下 |
| 分派 | 放行的交 triage;範圍清楚且能修的再交 bug-fixer,各自核對授權 |
| 記帳 | 各階段當下記錄用量,收班時彙整 |
| 交摘要 | 列出成果、未完成項目、成本與需要人處理的事 |
交接時,檔案裡的專案、輪次和問題編號要一致。下一位才知道自己拿到的是同一筆,不必回頭翻對話猜。獨立驗證也要用分開的上下文;做不到就留下待驗紀錄,不能自己宣布已確認。
從開班就記帳,收班才有數字可看
還有一件事,不能等收班才想起來:記帳。現行流程用 scripts/token-ledger.py,在準備、探索、驗證、把關、分派和收班這六段開始前,各留一個標記。這樣才分得出用量花在哪裡。
沿用剛才的示例輪次,開班時先執行這一行:
bash
python3 scripts/token-ledger.py --mark \
  --run 20260922_toolshop-oncall --stage setup
標記要在前置檢查之前留下。接著每進一站,依序使用 hunt、verify、gate、dispatch、wrapup。到了收班,再用下面這行彙整:
bash
python3 scripts/token-ledger.py --report 20260922_toolshop-oncall這些由值班流程負責,你不用每一站提醒。收報告時,再確認六段都有沒有記到、是否還有未歸類的用量,並把實際數字填回值班紀錄。工具拿不到的部分就明講,別猜一個數字補上。
預算到了就收班,記下做到哪裡、還剩哪些。7 月 30 日那輪漏了主流程用量,沒辦法證明它有守住預算;後來加了記帳機制,也要看新一輪結果,才能知道有沒有改善。
權限照約定走,值班不會自動升官
至於哪些事可以直接做,還是照我們事先說好的範圍。config/governance.yaml 把動作分成三層:
| 分級欄位 | 怎麼處理 |
|---|---|
autonomous | 已預先允許自行執行的動作 |
needs_review | 核對這次授權;已涵蓋就沿用,沒有就先交具體內容 |
forbidden | 本流程禁止,不能自行執行或改清單繞過 |
目前範例的前兩份清單都是空的,表示還沒透過這張表預先列入動作。讀檔、分析、準備草稿,不因此變成每一步都要問;其他未列的動作,則看使用者授權和各技能規則。通過開單檢查,只代表問題符合條件,開單權限還要另外核對。
如果要填設定,記得用現行名稱,例如 create_issue 是建立問題單,edit_product 是修改產品碼,create_pr 是建立合併請求。舊紀錄裡的 file_local_report、open_pr,就別直接貼進新設定了。
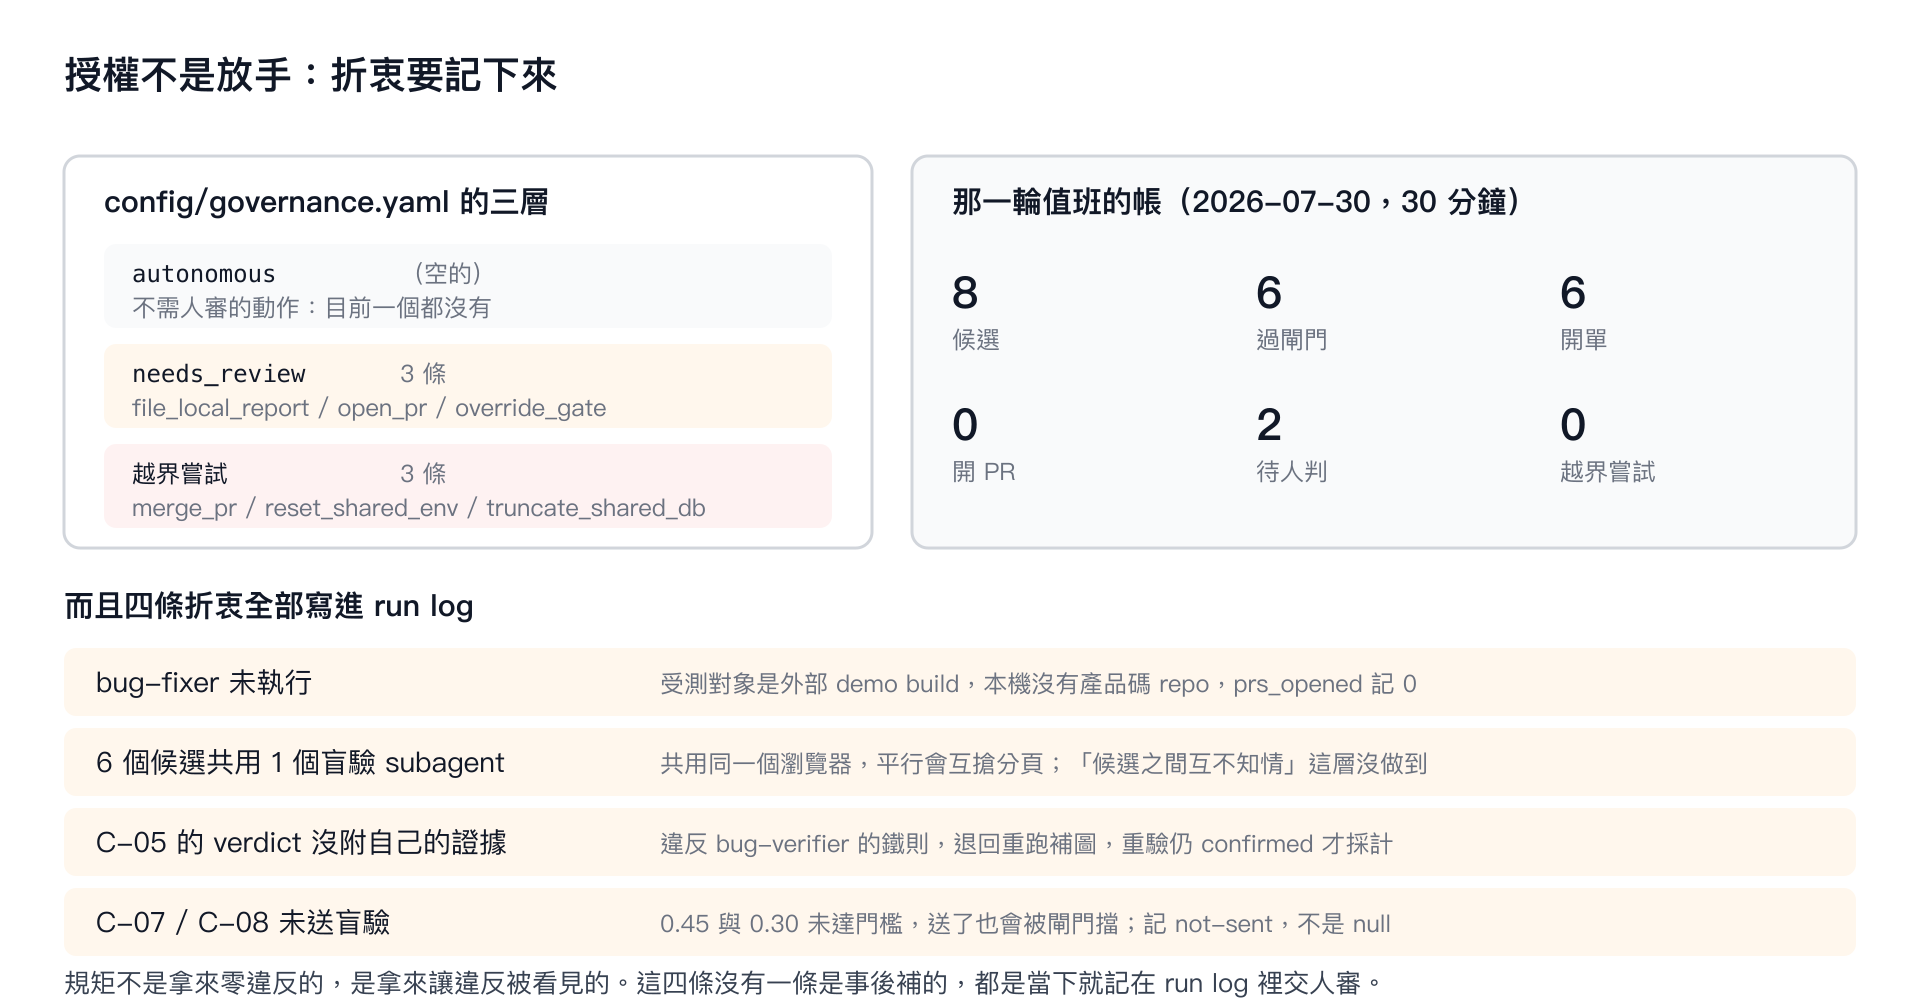
這張圖保留舊版動作名稱與當時結果。現在設定授權時,請以 config/governance.example.yaml 和現行交接規則為準。
禁止清單列的是 merge_pr、reset_shared_env、truncate_shared_db。助手不能自行改清單,也不能把一般確認當成解除禁止。需要例外處理時,依 override.require_reason 記下誰、何時、為什麼;開單條件仍照第 24 天核對,重複問題不能改成放行。
最後看一下 forbidden_attempts,也就是有沒有嘗試禁止的動作。不是 0 就要當成事故回報。這輪是 0,只能說紀錄裡沒有這種嘗試;要證明工具真的擋得住,還得另外查。把規則寫好,和工具已經限制好,不能算成同一件事。
今天學到什麼
回頭看這輪,助手交回六份本地問題單,也留下沒修復、盲驗有折衷、用量沒記全的紀錄。哪些做到了、哪些還沒做到,都看得見,我們才知道下一輪要補哪裡。
三十天走到這裡,你已經可以交給這位新同事不少工作了。接下來,把人工確認和校準紀錄補齊,再照相同流程多跑幾輪。等你們看清楚他哪些事做得穩、哪些地方仍需要幫忙,再決定下一次可以多交給他多少。
作者備忘錄 — 正式出版前應移除
章節大綱
- 前言 — 從逐站操作接到一輪值班。
- 開始之前 — 五站、範圍、預算與授權先備妥。
- 動手試試 — 手動呼叫提示詞與具體輪次路徑。
- 跑完之後 — 保留歷史數字與四條差距,不把後來成果算回舊輪次。
- 背後怎麼做 — 檔案交接、六階段計量、現行授權與舊紀錄的差異。
- 今天學到什麼 — 依實際交付與缺口決定下一輪改善。
參考資料
- Lisanne Bainbridge(1983)《Ironies of Automation》,Automatica 19(6) - 自動化把例行的部分接走,留給人的反而是最難的判斷,這篇是所有「人機分工」設計的起點
- David D. Woods、Erik Hollnagel(2005)《Joint Cognitive Systems: Foundations of Cognitive Systems Engineering》 - 人與自動化是一個共同體,設計要問的是「誰在什麼情況下負責什麼」,不是「自動化程度多高」
- Betsy Beyer et al. 編(2016)《Site Reliability Engineering》 - on-call 的紀律:可稽核的紀錄、事後檢討、以及為什麼要量測而不是憑感覺
- SAE International(2021)《J3016: Taxonomy and Definitions for Terms Related to Driving Automation Systems》 - 把自主性拆成分級而不是開關,並且明訂每一級由誰負責,是授權分級最成熟的類比
- 本專案
config/governance.yaml- 三層授權與留痕規則 - 本專案
skills/agents/duty-oncall/SKILL.md- 六步編排與鐵則 - 本專案
output/runs/2026-07-30.yaml- 實跑的值班紀錄,含四條 deviations